Nội dung chính
1. Vụ kiện gốc: ai tố ai, vì điều gì?
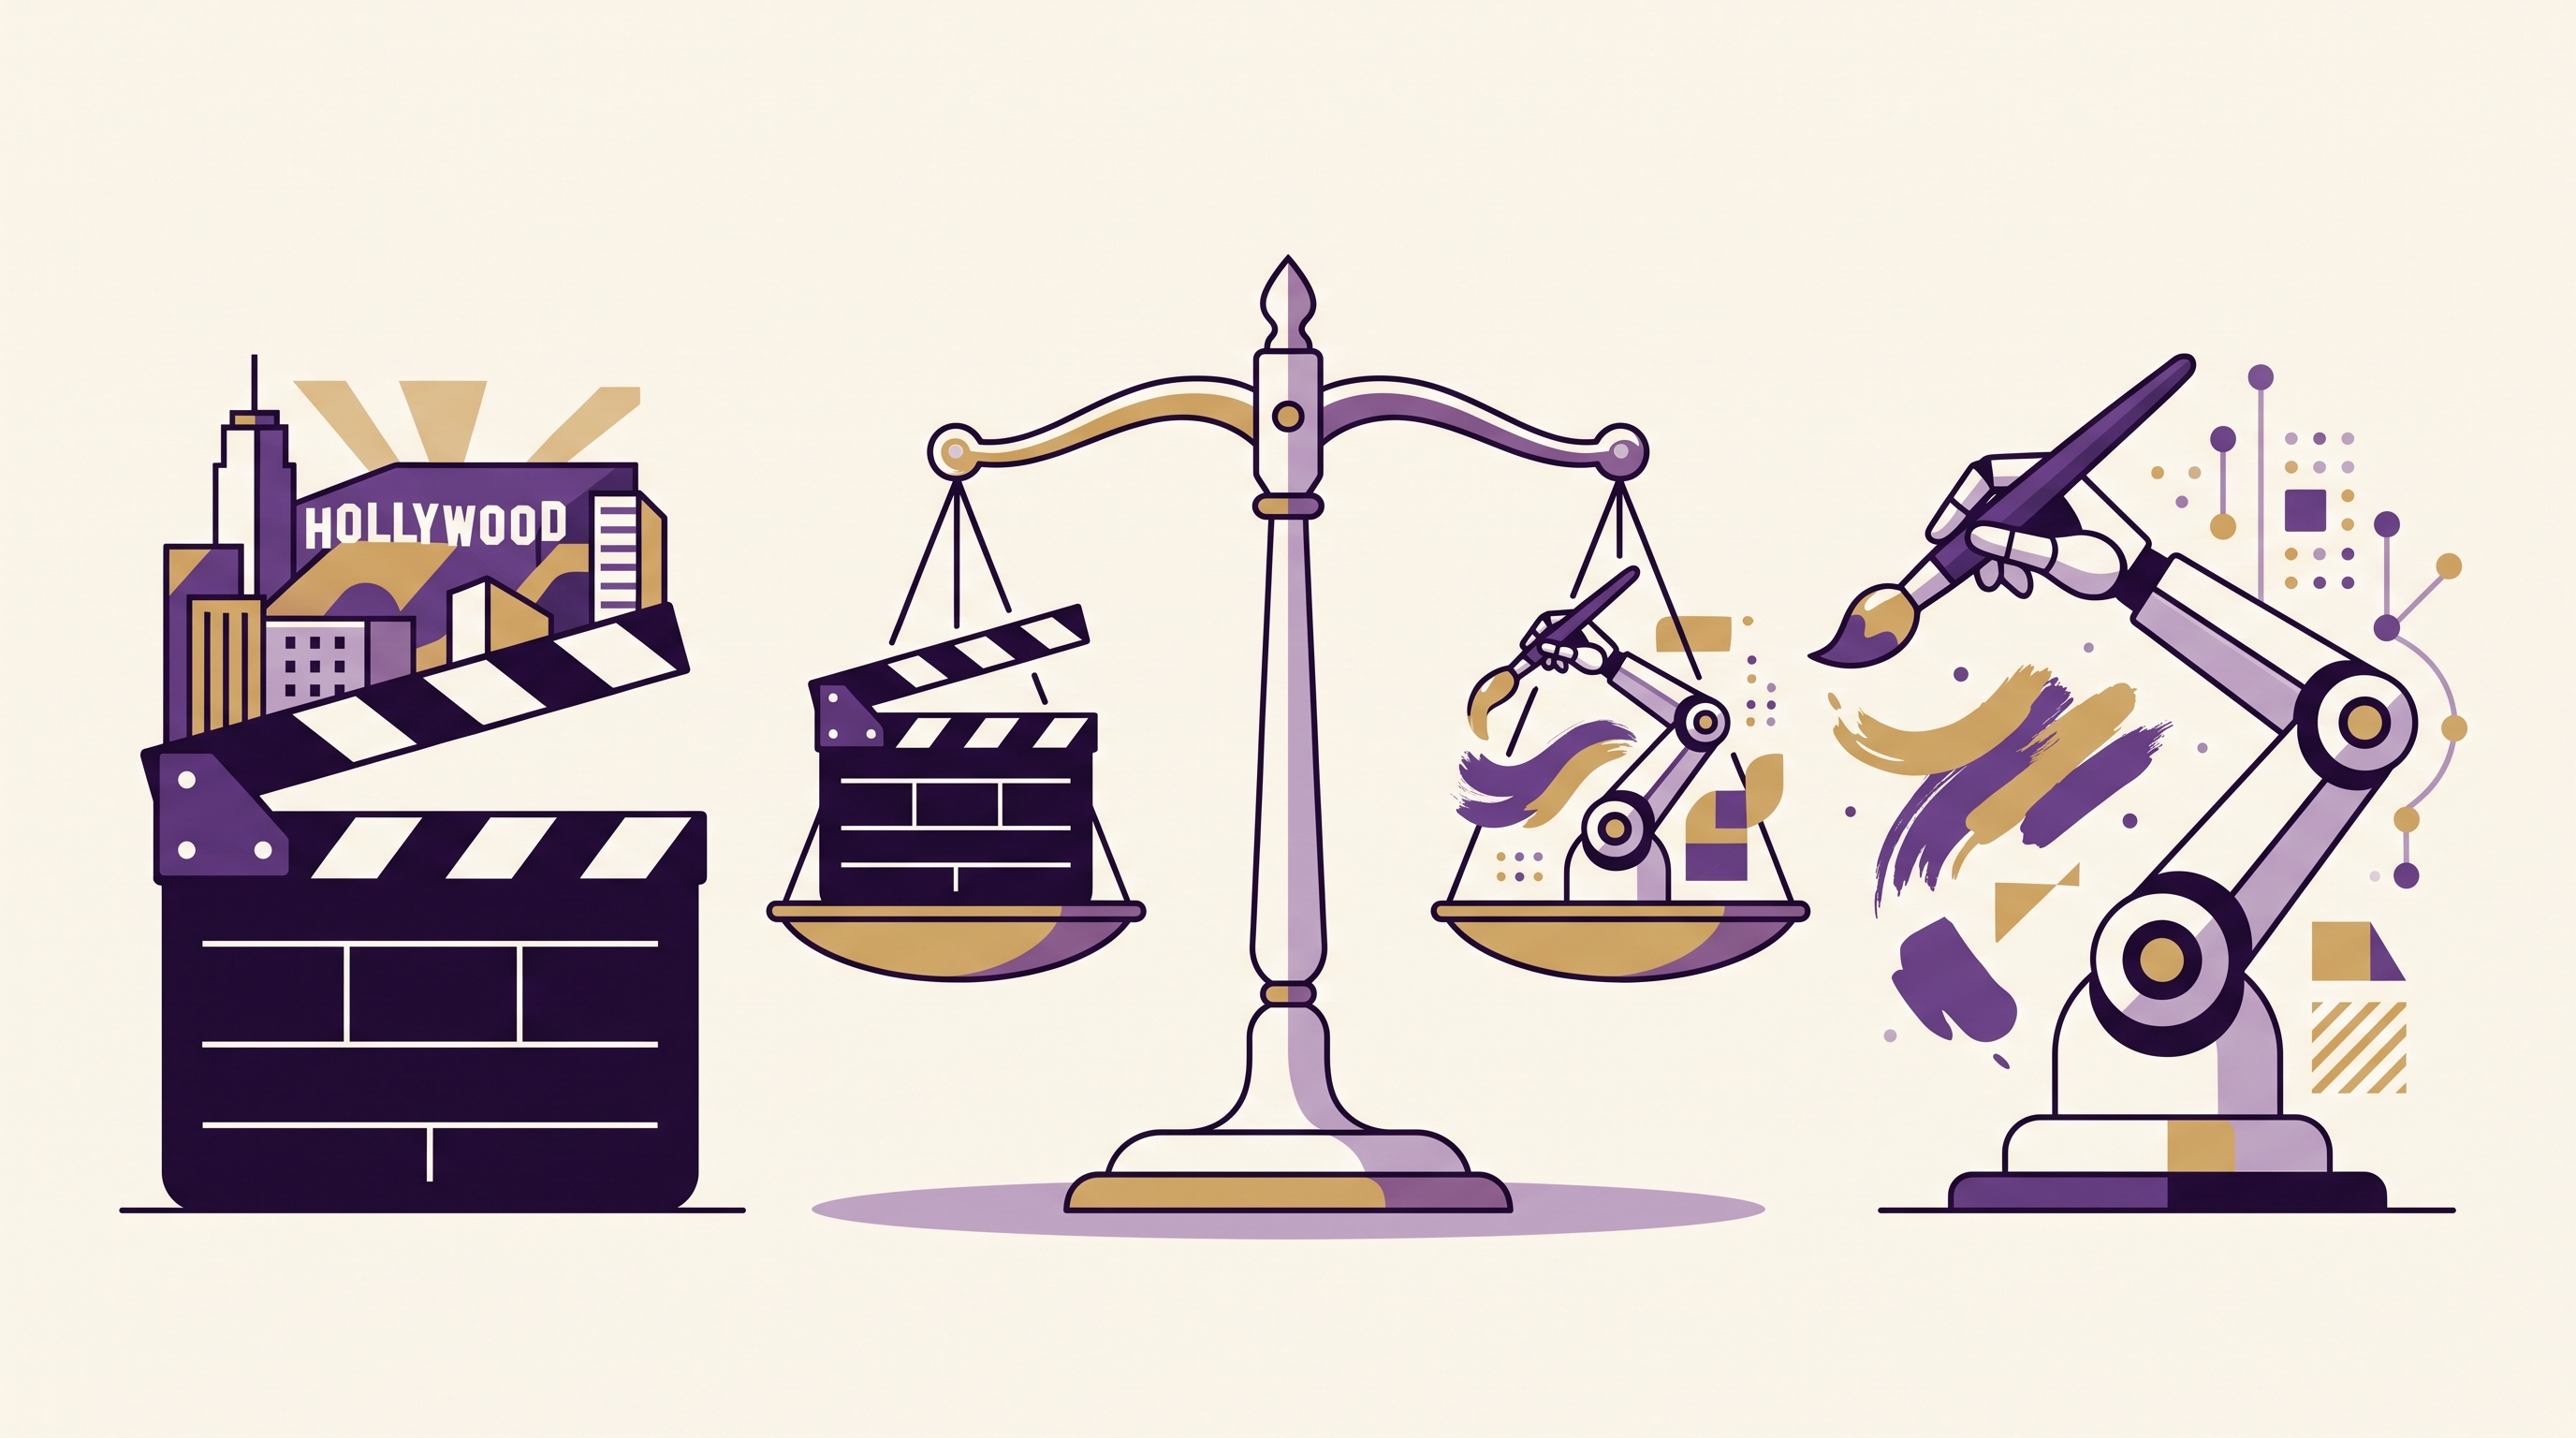
Ba hãng phim lớn nhất Hollywood, Disney, Universal và Warner Bros, cùng đứng đơn kiện Midjourney với lý do: mô hình AI tạo ảnh của startup này có thể sinh ra hình ảnh gần như giống hệt các nhân vật có bản quyền của họ, chỉ cần người dùng gõ vài từ khóa đơn giản. Đơn kiện nêu cụ thể các nhân vật như Bart Simpson, Darth Vader, Superman và Batman, những biểu tượng văn hóa đại chúng mà các hãng đã đầu tư hàng tỷ USD xây dựng và bảo vệ bản quyền suốt nhiều thập kỷ.
Về phía mình, Midjourney lập luận việc huấn luyện mô hình AI trên hình ảnh có bản quyền thuộc phạm vi "sử dụng công bằng" (fair use), một khái niệm pháp lý của Mỹ cho phép dùng tài liệu có bản quyền trong một số trường hợp nhất định, ví dụ nghiên cứu, phê bình, hoặc chuyển đổi mục đích sử dụng đủ sâu. Câu hỏi quan trọng không ai hỏi thẳng trong hầu hết vụ kiện bản quyền AI là: mô hình AI "học" từ dữ liệu có bản quyền để tạo ra thứ mới, liệu có khác gì con người học vẽ bằng cách xem tranh của người khác?
2. Nhưng có một nhưng: Midjourney đòi hỏi các hãng phim tự "lộ bài"
Điều thú vị không nằm ở lập luận fair use, mà ở chiến lược pháp lý mới của Midjourney trong giai đoạn thu thập chứng cứ (discovery): công ty này yêu cầu tòa buộc Disney, Universal và Warner Bros công khai toàn bộ cách họ tự dùng công cụ AI tạo hình nội bộ, bao gồm mọi prompt đã dùng và kết quả tạo ra, không chỉ những hình ảnh liên quan trực tiếp đến vụ kiện.
Một thẩm phán trước đó đã giới hạn phạm vi công khai của các hãng phim, chỉ buộc họ tiết lộ thông tin về việc dùng AI tạo ra nội dung "hướng đến người xem cuối" (consumer-facing), ví dụ cảnh phim, poster, trailer. Midjourney phản đối giới hạn này, cho rằng các hãng đang chọn lọc thông tin để công khai, cố tình giấu đi phần quan trọng nhất.
Trong đơn phản đối, Midjourney viết một câu đáng chú ý: "những tài liệu họ đang giữ lại chính là những tài liệu sẽ tiết lộ liệu, đằng sau cánh cửa đóng kín, họ có đang làm chính xác điều họ kiện Midjourney đã làm hay không." Câu hỏi quan trọng không ai muốn hỏi thẳng ở đây là: nếu các hãng phim tự dùng AI để phác thảo ý tưởng (storyboard) bằng dữ liệu chưa được cấp phép đầy đủ, liệu điều đó có biến hành vi này thành "tập quán ngành" bình thường, thay vì hành vi vi phạm bản quyền nghiêm trọng như họ đang cáo buộc Midjourney?
3. Phía các hãng phim nói gì?
David Singer, luật sư đại diện chính cho các hãng phim, gọi yêu cầu của Midjourney là một "chuyến đi câu cá" (fishing expedition), tức cố tình đòi hỏi thông tin không liên quan trực tiếp để làm phức tạp vụ kiện, thay vì phục vụ mục đích tố tụng thật sự. Theo lập luận của phía hãng phim, mục tiêu duy nhất của họ chỉ là ngăn chặn hành vi sao chép và tạo ra tác phẩm phái sinh (derivative works) trái phép từ nhân vật của mình, việc họ tự dùng AI nội bộ ra sao không liên quan đến câu hỏi đó.
Rủi ro thật sự ở đây, với cả hai phía, là chưa có tiền lệ pháp lý rõ ràng nào định nghĩa chính xác ranh giới giữa "học từ dữ liệu có bản quyền để sáng tạo" và "sao chép trái phép". Pháp lý hiện tại chưa rõ, nhưng rủi ro thực tế thì có: kết quả vụ kiện này, dù nghiêng về bên nào, nhiều khả năng sẽ được các vụ kiện AI tạo ảnh, tạo video khác đang chờ xử lý tại Mỹ tham khảo, dù chưa ai chắc mức độ ràng buộc thực tế của nó.
Điều này ảnh hưởng gì đến bạn?
Bạn đang dùng Midjourney, ChatGPT tạo ảnh, hoặc các công cụ AI tạo ảnh/video khác để làm nội dung cho công việc, thương hiệu cá nhân, hay khách hàng tại Việt Nam. Bạn có biết dữ liệu huấn luyện mô hình mình đang dùng đến từ đâu không? Câu trả lời trung thực là: hầu hết người dùng, kể cả người dùng chuyên nghiệp, không biết, và hiện tại pháp luật Việt Nam cũng chưa có quy định cụ thể xử lý câu hỏi này.
Điều bạn cần biết trước khi thương mại hóa nội dung tạo bằng AI: nếu bạn dùng AI tạo hình ảnh có phong cách hoặc chi tiết gần giống nhân vật, thương hiệu có bản quyền (kể cả không cố ý), rủi ro pháp lý vẫn tồn tại, đặc biệt nếu nội dung đó dùng cho mục đích thương mại, quảng cáo, hoặc bán ra thị trường quốc tế nơi luật bản quyền Mỹ, EU có thể áp dụng. Với freelancer, agency thiết kế, hoặc người làm nội dung tại Việt Nam đang dùng AI tạo ảnh cho khách hàng nước ngoài, lời khuyên thực tế là: tránh prompt gợi ý trực tiếp tên nhân vật, thương hiệu nổi tiếng, và luôn kiểm tra lại output trước khi giao cho khách hàng dùng vào mục đích thương mại.
Vụ kiện này cho thấy một điều: ngay cả các hãng phim đang đi kiện AI cũng không tránh khỏi bị hỏi ngược về cách họ tự dùng AI. Câu hỏi "ai chịu trách nhiệm khi AI tạo ra nội dung vi phạm bản quyền" vẫn chưa có câu trả lời chắc chắn, ở cả Mỹ và Việt Nam, và người dùng cuối, bao gồm bạn, vẫn là người gánh rủi ro pháp lý cao nhất nếu không cẩn trọng.
Số liệu & thống kê
- Ba hãng phim đứng đơn kiện: Disney, Universal, Warner Bros.
- Nhân vật được nêu tên trong đơn kiện: Bart Simpson, Darth Vader, Superman, Batman.
- Phạm vi công khai hiện tại (theo lệnh tòa trước đó): chỉ giới hạn ở nội dung AI "hướng đến người xem cuối" (consumer-facing).
Sources
| # | Title | URL | Ghi chú |
|---|---|---|---|
| 1 | Midjourney wants Hollywood studios to reveal the details of their AI usage | https://techcrunch.com/2026/07/04/midjourney-wants-hollywood-studios-to-reveal-the-details-of-their-ai-usage/ | TechCrunch, 4/7/2026 |