Vấn đề thực ra có hai tầng
Câu chuyện trên xảy ra trước kỷ nguyên AI coding assistant. Bây giờ thì sao? Chúng ta có Claude, Copilot, Cursor – những công cụ mạnh đến mức đôi khi tôi không tin được. Nhưng cái vấn đề cốt lõi vẫn còn đó, thậm chí còn phức tạp hơn.
Tầng một vẫn như cũ: tribal knowledge gap – hệ thống có logic mà không ai ghi lại, context bị mất theo từng lần nghỉ việc.
Tầng hai là vấn đề mới: AI goldfish memory – mỗi session mới, assistant bắt đầu từ con số không. Bạn dành 10 phút giải thích kiến trúc, rồi session kết thúc. Hôm sau mở lại, nó hỏi lại từ đầu.
Tôi đã có cuộc trò chuyện kiểu này không biết bao nhiêu lần:
Tôi: "Thêm rate limiter vào auth routes."
Agent: "Được. Bạn đang dùng JWT hay session-based auth?"
Tôi: "... Mình đã nói 6 session trước rồi."
Context window bị đốt vào việc re-explain. Agent mất thời gian re-discover. Token bill tăng. Và vẫn không giải quyết được cái câu hỏi tại sao InventoryService lại làm vậy.
LLM Wiki Pattern: Cái này không phải RAG bình thường
Đây là điểm quan trọng mà tôi muốn làm rõ, vì nhiều người dễ nhầm lẫn.
RAG (Retrieval-Augmented Generation) truyền thống hoạt động như thế này: bạn chunk files, embed, lưu vào vector DB, rồi mỗi lần query thì pull ra những đoạn liên quan. Nó works, nhưng có một hidden cost: LLM phải làm lại công việc extraction trên mỗi query. Kiến thức không compound – lần hỏi thứ 100 không thông minh hơn lần hỏi thứ 1.
LLM Wiki Pattern khác ở chỗ nó thêm một tầng trung gian:
Raw Sources (code, docs, meeting notes)
        ↓ ingest một lần
Wiki Layer (markdown pages do LLM maintain)
        ↓ query bất kỳ lúc nào
Synthesized Answers + Citations
Khi bạn add một source mới, LLM đọc nó, extract entities và concepts, tích hợp vào wiki đang có, cập nhật cross-references, và flag contradictions. Lần query tiếp theo tốt hơn vì wiki giàu hơn – không phải vì bạn chunk tốt hơn.
Sự khác biệt thực sự: RAG là stateless cache, LLM Wiki là stateful memory.
Ví von đơn giản: RAG giống như bạn tra từ điển mỗi lần cần. LLM Wiki giống như bạn đang xây một chuyên gia trong nhà – lần đầu nó học, những lần sau nó nhớ và liên kết.
Triển khai thực tế: Từ concept đến codebase
Tôi sẽ đi qua hai approach phổ biến nhất hiện tại.
Approach 1: DocuFlow – MCP Server cho codebase
DocuFlow là một open-source MCP server. Nó hoạt động với Claude, Copilot, Cursor và bất kỳ MCP-compatible agent nào.
Workflow cụ thể:
# 1. Cài và khởi tạo
npm install -g @doquflow/cli
cd your-project
docuflow init

# 2. Viết source documents vào .docuflow/sources/
# Đây là phần QUAN TRỌNG – bạn curate, không phải AI
.docuflow/sources/
├── overview.md         # Tech stack, env vars, what this does
├── architecture.md     # System diagram, request lifecycle
├── api-reference.md    # Endpoints với request/response
└── developer-guide.md  # Setup, conventions, gotchas

# 3. Sync để generate wiki
docuflow sync
Từ 5 source documents, DocuFlow generate 71 wiki pages – mỗi entity, concept và relationship có trang riêng với cross-references. Bây giờ khi bạn hỏi agent về token refresh flow, nó không đọc auth.ts – nó đọc wiki page "Refresh Token" đã có context đầy đủ và link tới các trang liên quan.
Và điểm hay nhất: kiến thức tích lũy. Nếu agent trả lời một câu hỏi phức tạp và save lại:
save_answer_as_page("What happens when refresh token expires?")
→ wiki/syntheses/refresh-token-expiry.md
Lần sau, agent tiếp theo sẽ có câu trả lời tốt hơn mà không cần ai lặp lại.
Approach 2: Knowledge Graph – Token Tax Reduction
Nếu bạn không muốn thêm một MCP server mới, approach này đơn giản hơn và đặc biệt hiệu quả với large codebase.
Ý tưởng từ Andrej Karpathy: thay vì dump raw source vào context, xây một knowledge graph làm cache layer. Tool phổ biến là Graphify.
pip install graphify
graphify analyze --path ./src --module-name "OrderService"
Output là ba files:
GRAPH_REPORT.md(~9KB) – cho Copilot, Cursor, Claude đọcgraph.json(~1MB) – cho GraphRAG queriesgraph.html– cho human review
9KB thay thế megabytes của source scanning. Mỗi session.
Điều thú vị nhất không phải là graph – mà là cái graph tiết lộ. Sau khi chạy trên codebase 5 năm tuổi, bạn sẽ thấy "god nodes" – những functions, services hoặc utilities mà toàn bộ hệ thống phụ thuộc vào. Những cái mà khi touch vào, cả team run-over đến nhìn.
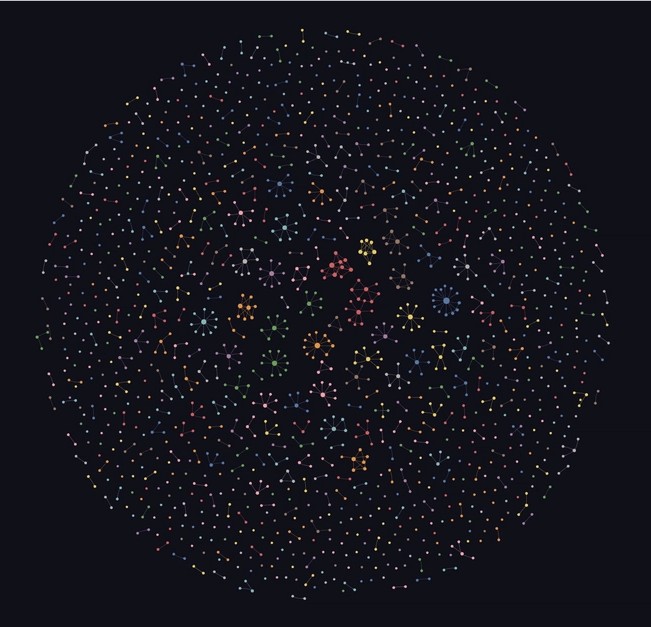
Với team của tôi, một codebase 1,000 files cho ra kết quả:
- 1,600+ unique nodes
- 4,000+ edges
- 28 structural communities
- Zero LLM tokens để build
Bước cuối là wire vào agent instructions:
# Agent Instructions
Before answering architecture questions,
read: graphify-out/GRAPH_REPORT_MERGED.md

God nodes (proceed with caution):
- OrderService.ProcessPayment
- InventoryService.UpdateStock
- AuthMiddleware.ValidateToken
Bây giờ mọi agent start session với architectural knowledge đã loaded. Không cần giải thích lại tại sao InventoryService gọi OrderService.
Bài học cứng từ 6 tháng áp dụng
Tôi đã làm sai vài thứ trước khi hiểu đúng. Để tránh bạn mất thời gian:
1. Curate source documents – đừng dump toàn bộ code
LLM Wiki không phải "nhét hết code vào". Bạn phải viết các source documents có chất lượng. Câu hỏi đúng không phải "file nào cần add?" mà là "câu hỏi nào dev mới sẽ hỏi trong 6 tháng đầu?"
2. Graph stale là nguy hiểm hơn không có graph
Một knowledge graph lỗi thời dẫn agent đến kết luận sai còn tệ hơn không có gì. Rule tôi áp dụng: regenerate sau mỗi sprint, hoặc trigger bằng git hook khi structural files thay đổi.
3. God nodes phải được document ưu tiên
Đừng document đều mọi thứ. Dùng graph để identify god nodes, rồi tập trung document những node đó trước. 20% nodes giải thích 80% câu hỏi.
4. Tribal knowledge vẫn là con người phải viết
AI không tự biết "tại sao" – nó chỉ biết "cái gì". Cái lý do InventoryService gọi OrderService theo kiểu đó phải có người ghi lại trước. LLM Wiki không thay thế documentation – nó amplify documentation tốt.
Cái tôi thực sự học được
Có một câu tôi đọc trong một post kỹ thuật và không thể quên được:
"Tribal knowledge không phải vấn đề documentation – đó là vấn đề runtime dependency."
Nghe có vẻ academic, nhưng khi bạn ngồi đó lúc 2 giờ sáng debug production và context duy nhất bạn có là một wiki page viết năm 2021, thì câu đó rất cụ thể.
LLM Wiki không giải quyết vấn đề knowledge capture – người viết docs tốt vẫn phải là con người. Nhưng nó giải quyết vấn đề knowledge accessibility: thay vì kiến thức nằm trong đầu người hoặc buried trong Confluence, nó được đặt đúng chỗ – trong context của agent đang làm việc với bạn.
Với .NET codebase, tôi recommend bắt đầu từ level thấp nhất: tạo một CODEBASE.md ở root với architecture overview, list ra các services chính, và giải thích các "why" mà code không nói lên được. Đặt nó vào CLAUDE.md hoặc .github/copilot-instructions.md. Đây là bước nhỏ nhất nhưng impact ngay lập tức nhất.
Sau đó, nếu codebase lớn hơn 200 files, mới nghĩ đến knowledge graph hay full DocuFlow setup.
Believe in basic – bắt đầu từ cái đơn giản nhất trước.
Codebase của bạn hiện tại có một curated CODEBASE.md không? Hay AI assistant của bạn vẫn đang "đọc lại từ đầu" mỗi sáng?
Tôi tò mò về approach của các bạn – đặc biệt những ai đang làm việc với legacy codebase nhiều năm tuổi. Comment bên dưới nhé.
/Son Do - believe in basic
#1percentbetter #aiarchitecture #llm #codebase #developertools